WEEK 8 · 온라인 보강
Python과 데이터 분석
Python과 데이터 분석
종합 정리
자료형과 자료구조 · 조건과 반복 · 데이터 처리와 해석
지금까지 배운 내용은 어떻게 연결될까?
자료형·자료구조값을 어떤 형태로 저장하는가?
조건·반복·함수어떤 값에 어떤 처리를 적용하는가?
NumPy·Pandas배열과 표 전체를 어떻게 처리하는가?
시각화·해석무엇을 비교했고 어떤 결론을 내릴 수 있는가?
복습의 목표: 실행 결과를 예측하고, 처리 방법을 선택한 이유를 설명한다.
자료형이 연산의 의미를 결정한다
| 코드 | 결과 | 판단할 내용 |
|---|---|---|
"20" + "5" | "205" | 문자열 연결 |
int("20") + 5 | 25 | 형변환 후 숫자 계산 |
[20, 5] * 2 | [20, 5, 20, 5] | 리스트 반복 |
7 / 2 · 7 // 2 · 7 % 2 | 3.5 · 3 · 1 | 나눗셈 · 몫 · 나머지 |
input()의 결과는 문자열이다. 숫자처럼 보이는 값과 계산할 수 있는 숫자 자료형을 구분한다.문자열 정리와 숫자 변환은 순서가 있다
raw = " 3,000 "

text = raw.replace(" ", "")
text = text.replace(",", "")
amount = int(text)

print(amount + 500)
- 1공백 제거:
" 3,000 " → "3,000" - 2쉼표 제거:
"3,000" → "3000" - 3정수 변환:
"3000" → 3000 - 4숫자 계산:
3000 + 500 → 3500
replace()를 실행해도 결과는 문자열이다. int("3,000")은 쉼표 때문에 오류가 발생한다.리스트·튜플·딕셔너리·세트의 선택 기준
| 구조 | 값을 찾는 기준 | 변경·중복 | 사용 예 |
|---|---|---|---|
리스트 [ ] | 위치 | 변경 가능 · 중복 허용 | 순서가 있는 작업 데이터 |
튜플 ( ) | 위치 | 항목 변경 불가 · 중복 허용 | 좌표, 고정된 설정 묶음 |
딕셔너리 {키: 값} | 키 | 키는 중복 불가 · 값 변경 가능 | 열 이름에 대응하는 값 |
세트 {값, 값} | 원소의 포함 여부 | 중복 제거 · 위치로 접근 불가 | 고유 항목, 합집합·교집합 |
괄호 모양만 외우기보다 순서·변경 가능 여부·중복·접근 방법을 함께 판단한다.
인덱싱과 슬라이싱: 끝 위치는 포함하지 않는다
위치01234
값1020304050
음수-5-4-3-2-1
| 식 | 결과 |
|---|---|
values[-1] | 50 |
values[1:4] | [20, 30, 40] |
values[::2] | [10, 30, 50] |
values[::-1] | [50, 40, 30, 20, 10] |
values = [10, 20, 30, 40, 50][시작:끝:간격]에서 생략한 값과 음수 인덱스의 의미를 함께 확인한다.대입과 복사: 이름이 다른데 왜 함께 바뀔까?
a = [[1, 2], [3, 4]]
b = a
c = a.copy()

b[0][0] = 9
c.append([5, 6])

print(a)
print(c)
ab같은 바깥 리스트
c새 바깥 리스트
안쪽 리스트는 공유
안쪽 리스트는 공유
a: [[9, 2], [3, 4]]
c: [[9, 2], [3, 4], [5, 6]]
b = a는 복사가 아니다. a.copy()는 얕은 복사이다. 중첩된 항목까지 독립적으로 복사하려면 copy.deepcopy()를 사용한다.딕셔너리는 키로 조회하고 키·값 쌍으로 순회한다
record = {"region": "논산", "count": 12}

print(record["count"])
print(record.get("year", 2026))

for key, value in record.items():
print(key, value)| 사용 방법 | 의미 |
|---|---|
record["count"] | 키에 대응하는 값 조회 |
record["year"] | 키가 없으면 KeyError |
record.get("year", 2026) | 키가 없으면 기본값 반환 |
record.items() | 키와 값을 함께 순회 |
분석 자료에서 항목명과 실제 키가 일치하는지 확인한다. 기본값이 실제 관측값인지도 구분한다.
조건식: 경계값과 논리 연산자를 함께 확인한다
score = 80
attendance = 70

print(score >= 80 and attendance >= 75)
print(score >= 80 or attendance >= 75)

if score >= 90:
    grade = "A"
elif score >= 80:
    grade = "B"
else:
    grade = "C"
| 식 | 결과 |
|---|---|
True and False | False |
True or False | True |
score >= 80 | 80도 포함 |
score > 80 | 80은 제외 |
첫 출력: False
둘째 출력: True
grade: B
if–elif–else는 위에서부터 검사하고 처음 참인 분기 하나를 실행한다. 조건의 순서와 들여쓰기가 결과를 바꾼다.반복문: 반복 범위·종료 조건·누적 위치
total = 0
for n in range(1, 6):
    if n % 2 == 0:
        total += n
print(total)

count = 3
while count > 0:
    print(count)
    count -= 1
- 1
range(1, 6): 1부터 5까지 - 2
n % 2 == 0: 짝수만 선택 - 3반복문 밖에서 초기화한
total에 누적 - 4
while: 조건을 거짓으로 만드는 값 변경 필요
total: 6
while 출력: 3, 2, 1
누적 변수를 반복문 안에서 0으로 초기화하면 이전 결과가 사라진다.
break는 현재 반복문을 종료한다.함수: 출력하는 것과 반환하는 것은 다르다
def show_rate(cases, population):
    print(cases / population * 100)

def calc_rate(cases, population):
    return cases / population * 100

a = show_rate(1200, 100000)
b = calc_rate(1200, 100000)
print(a, b)
print()
화면에 보여준다.
함수의 계산 결과를 돌려주는 역할은 아니다.
return
호출한 곳에 결과를 돌려준다.
다른 계산·조건식·변수 대입에 사용할 수 있다.
show_rate가 출력: 1.2
마지막 print의 결과: None 1.2
리스트 연산에서 배열·표 전체의 계산으로
scores = [80, 90, 70]
print(scores * 2)

import numpy as np
arr = np.array(scores)
print(arr * 2)
print(arr.mean())
리스트: [80, 90, 70, 80, 90, 70]
NumPy: [160 180 140]
평균: 80.0
Pandas에서도 열 전체를 계산
df["cases"] / df["population"] * 100
각 행의 대응하는 값으로 같은 계산을 수행한다.
import numpy as np, import pandas as pd: 라이브러리를 불러와 별칭으로 사용한다.오류 메시지에서 먼저 확인할 내용
| 오류 | 대표 상황 | 확인할 내용 |
|---|---|---|
| TypeError | 문자열과 숫자를 더함 / 튜플 항목 수정 | 실제 자료형과 허용되는 연산 |
| ValueError | int("3,000") | 값의 형식과 변환 순서 |
| IndexError | [10, 20][2] | 0부터 시작하는 유효 위치 |
| KeyError | 딕셔너리·표에 없는 이름 사용 | 실제 키 또는 열 이름 |
| IndentationError | 블록의 들여쓰기가 맞지 않음 | 조건·반복·함수의 범위 |
오류가 발생한 줄·값·자료형을 확인한다. 코드를 고치기 전에 실행이 멈춘 이유를 설명해 본다.
종합 코드 해석: 자료 정리부터 조건 비교까지
records = [
    {"region": "A", "cases": "1,200", "population": "100,000"},
    {"region": "B", "cases": "300", "population": "20,000"},
    {"region": "C", "cases": "0", "population": "0"}
]
def calc_rate(cases, population):
    return cases / population * 100

threshold = 1.3
for row in records:
    cases = int(row["cases"].replace(",", ""))
    population = int(row["population"].replace(",", ""))
    if population > 0:
        rate = calc_rate(cases, population)
        if rate >= threshold:
print(row["region"], round(rate, 2))- 1리스트에서 딕셔너리를 하나씩 꺼낸다.
- 2문자열을 정리하고 정수로 바꾼다.
- 3인구가 0보다 큰지 확인한다.
- 4함수로 비율을 계산하고 기준값과 비교한다.
| 지역 | 계산 | 선택 |
|---|---|---|
| A | 1.2% | 제외 |
| B | 1.5% | 출력 |
| C | 분모 0 | 계산 제외 |
계산 연습용 가상 자료이다. 최종 출력:
B 1.5종합 실습: 조건을 바꾸면 무엇이 달라질까?
threshold = 1.0

# 종합 코드의 반복문을 다시 실행한다.
A 1.2
B 1.5
- 1기준을 1.3에서 1.0으로 변경한다.
- 2반복문을 다시 실행하고 선택된 지역을 확인한다.
- 3인구가 0인 C지역이 여전히 제외되는 이유를 설명한다.
- 4조건을 달리 적용한 결과와 그 이유를 설명한다.
값 하나를 바꾸는 데서 끝내지 않고 어떤 조건에 의해 결과가 달라졌는지 설명한다.
리스트의 반복 처리와 DataFrame의 열 계산
rows = [
    {"region": "A", "cases": 1200, "population": 100000},
    {"region": "B", "cases": 300, "population": 20000}
]
import pandas as pd
df = pd.DataFrame(rows)
df["rate"] = df["cases"] / df["population"] * 100| region | cases | population | rate |
|---|---|---|---|
| A | 1200 | 100000 | 1.2 |
| B | 300 | 20000 | 1.5 |
한 행은 관측 대상 하나, 한 열은 항목 하나이다. 자료구조는 달라도 계산식과 비교 기준은 같다.
CSV를 읽은 뒤에는 자료의 구조부터 확인한다
raw_df = pd.read_csv(url)
raw_df.head()
raw_df.info()
raw_df[["tot_cases", "new_cases"]].isna().sum()
- 1한 행의 의미: 일별인가, 주간인가?
- 2열 이름: 날짜와 분석할 값은 무엇인가?
- 3자료형: 숫자가 문자열로 읽혔는가?
- 4결측값: 어느 열에 얼마나 있는가?
| end_date | tot_cases | new_cases |
|---|---|---|
| 04/26/2023 | 372,862 | 833 |
| 05/03/2023 | 373,610 | 748 |
| 05/10/2023 | 374,264 | 654 |
6주차 하와이 자료의 실제 마지막 3행이다. tot_cases는 누적값, new_cases는 주간 신규값이다.
한 열과 여러 열을 선택하면 결과의 차원이 다르다
one = raw_df["tot_cases"]
two = raw_df[["end_date", "tot_cases"]]

print(type(one).__name__)
print(type(two).__name__)

df = raw_df[
    ["end_date", "tot_cases", "new_cases"]
].copy()
| 선택 | 결과 |
|---|---|
df["열"] | Series: 1차원 |
df[["열"]] | DataFrame: 2차원 |
df[["열1", "열2"]] | DataFrame: 여러 열 |
분석에 필요한 열만 선택
선택할 이름을 리스트로 묶어 전달한다.
이후 수정할 작업용 표는 복사하여 만든다.
조건식은 각 행에 대한 참·거짓의 배열이다
mask = (
    (df["new_cases"] >= 1000) &
    (df["end_date"] >= "2022-01-01")
)
selected = df[mask].copy()| new_cases | 날짜 조건 | 결과 |
|---|---|---|
| 800 | True | False |
| 1200 | True | True |
| 1500 | False | False |
숫자·날짜 자료형 정리 후 실행한다. 각 조건을 괄호로 감싸고, 행별 결합에는
&·|를 사용한다. Python의 and·or와 구분한다.결측값·0·문자열 "0"은 같은 값이 아니다
| 상태 | 의미 | 처리 시 판단 |
|---|---|---|
| 결측값 NaN | 관측·입력·집계된 값이 없음 | 원인과 분석에 필요한 열 확인 |
| 숫자 0 | 실제로 0으로 기록된 값 | 분모인지, 측정 결과인지 구분 |
문자열 "0" | 문자 형태로 저장된 값 | 계산 전 숫자 자료형으로 변환 |
df = df.dropna(
    subset=["tot_cases", "new_cases"]
).copy()
다른 열에 값이 없다는 이유로 필요한 행까지 제거하지 않는다.
결측값을 0으로 채우면 누락을 실제 0으로 바꾸게 된다.
날짜 변환·정렬·색인은 서로 다른 작업이다
- 1변환
df["end_date"] = pd.to_datetime(df["end_date"]) - 2정렬
df = df.sort_values("end_date") - 3색인 지정
df = df.set_index("end_date")
| 작업 | 목적 |
|---|---|
| 날짜 자료형 변환 | 날짜로 비교·추출·계산 |
| 날짜순 정렬 | 시간의 흐름에 맞게 표시 |
| 날짜 색인 지정 | 날짜를 행의 기준으로 조회·결합 |
날짜 색인은 표의 행을 구분하는 기준이다. 정렬했다고 색인이 자동으로 날짜가 되지는 않는다.
데이터 결합은 행 번호가 아닌 날짜를 맞춘다
korea = pd.Series(
    [10, 12], index=["01-05", "01-12"]
)
hawaii = pd.Series(
    [8, 9], index=["01-12", "01-19"]
)
compare = pd.concat(
    [korea.rename("Korea"),
     hawaii.rename("Hawaii")], axis=1
)| 날짜 색인 | Korea | Hawaii |
|---|---|---|
| 01-05 | 10 | NaN |
| 01-12 | 12 | 8 |
| 01-19 | NaN | 9 |
공통 날짜 01-12에서 비교할 값은 12와 8이다.
결합 원리를 설명하기 위한 가상 자료이다. 실제 분석에서는 연도를 포함한 날짜 색인을 사용한다.
비교 지표: 건수·비율·단위를 먼저 맞춘다
| 계산 연습용 지역 | 신고 건수 | 인구 | 인구 대비 비율 |
|---|---|---|---|
| A | 10,000건 | 1,000,000명 | 1% |
| B | 5,000건 | 100,000명 | 5% |
비율(%) = 비교할 건수 ÷ 전체 기준값 × 100
지역을 비교하려면 날짜·집계 기간·분모·단위가 같아야 한다. 건수가 많은 지역이 비율도 높은 것은 아니다.
누적값과 신규값은 서로 다른 질문에 답한다
| 구분 | 답하는 질문 | 주의할 계산 |
|---|---|---|
| 누적 확진 신고 건수 | 그 시점까지 얼마나 합산되었는가? | 누적값들을 합하면 같은 신고가 반복 집계됨 |
| 주간 신규 확진 신고 건수 | 그 한 주 동안 얼마나 새로 집계되었는가? | 일별 신규값과 직접 비교하지 않음 |
누적값이 증가했다
해당 시점까지의 합계가 커졌다는 뜻이다.
매주 신규값도 계속 커졌다는 뜻은 아니다.
신고 건수 ÷ 인구
누적 신고 건수를 인구로 나눈 지표이다.
재감염 등이 있어 고유 확진자의 비율과 다를 수 있다.
분석 목적에 따라 그래프를 선택한다
막대그래프
범주 간 크기 비교
지역별·유형별 수치를 비교한다.
선 그래프
시간에 따른 변화
날짜순으로 값의 변화를 살펴본다.
히스토그램
수치 자료의 분포
값을 구간으로 나누어 빈도를 본다.
제목에는 비교 대상과 지표를, 축에는 항목과 단위를 표시한다. 여러 계열을 비교하면 범례를 넣는다.
위 도식은 그래프의 형태를 설명하기 위한 가상 자료이다.
종합 코드: 하와이 CSV 정리와 비율 계산
df = raw_df[["end_date", "tot_cases", "new_cases"]].copy()
df = df.dropna(subset=["tot_cases", "new_cases"])
df["end_date"] = pd.to_datetime(df["end_date"])
for col in ["tot_cases", "new_cases"]:
    df[col] = (
        df[col].astype(str).str.replace(",", "", regex=False)
        .astype(int)
    )
df = df.sort_values("end_date")
selected = df[
    (df["end_date"] >= "2022-01-01") &
    (df["end_date"] <= "2022-12-31")
].copy()
selected["cases_pct"] = selected["tot_cases"] / 1_455_271 * 100
- 1필요한 열 선택
- 2계산에 필요한 값의 결측 여부 확인
- 3날짜·숫자 자료형 정리
- 4날짜순 정렬과 분석 기간 선택
- 5인구 대비 비율 계산
처리 순서를 바꾸면 결과가 달라질 수 있다. 문자열 상태로 숫자를 비교하거나, 날짜를 맞추기 전에 자료를 결합하지 않는다.
실제 결과: 누적 비율과 주간 신규값의 차이
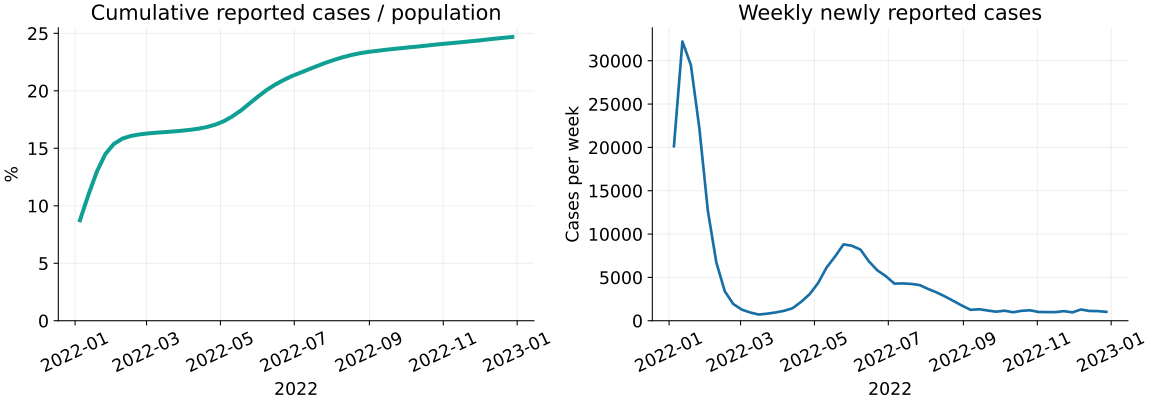
왼쪽: 누적 신고 비율은 전반적으로 증가한다.
오른쪽: 주간 신규 신고 건수는 증가와 감소를 반복한다.
출처: 6주차 CDC 하와이 보관 자료의 2022년 집계. 인구는 수업에서 사용한 2020년 인구조사 값 1,455,271명으로 고정.
종합 점검: 결과가 이상할 때 먼저 볼 것
| 문제 상황 | 원인 | 수정 방향 |
|---|---|---|
int("3,000") 오류 | 문자열 형식 미정리 | 쉼표 제거 후 숫자 변환 |
행별 조건식에 and 사용 | 하나의 참·거짓과 Series를 혼동 | 괄호를 씌운 조건에 & 적용 |
| 한국·하와이의 첫 행끼리 비교 | 행 순서가 같은 날짜를 보장하지 않음 | 날짜 색인을 기준으로 결합 |
| 누적값의 합계를 기간 신규 건수로 해석 | 같은 신고 건수가 여러 번 합산됨 | 지표의 정의와 집계 기간 재확인 |
오류가 없다는 것과 분석이 올바르다는 것은 다르다. 실행 결과와 계산 기준을 함께 확인한다.
종합 실습: 분석 기간을 바꾸고 결과 설명하기
start_date = "2021-01-01"
end_date = "2021-12-31"

selected = df[
    (df["end_date"] >= start_date) &
    (df["end_date"] <= end_date)
].copy()
selected["cases_pct"] = (
    selected["tot_cases"] / 1_455_271 * 100
)
- 1기간 선택과 비율 계산을 다시 실행한다.
- 2그래프도 다시 실행한다.
- 3가로축과 관측 건수가 바뀌었는지 확인한다.
- 4누적값과 주간 신규값을 구분하여 설명한다.
시작일 변수만 바꾸고 그래프 셀만 다시 실행하면, 이전에 만든
selected가 남아 있을 수 있다.종합 정리 및 온라인학습활동
| 코드를 읽을 때 | 분석 결과를 읽을 때 |
|---|---|
| 실제 자료형과 자료구조는 무엇인가? | 한 행이 나타내는 관측 단위는 무엇인가? |
| 어떤 조건과 범위가 적용되는가? | 비교하는 날짜·기간·단위가 같은가? |
| 값은 복사되었는가, 공유되는가? | 결측값과 0을 구분했는가? |
| 함수가 무엇을 반환하는가? | 누적값·신규값·비율을 구분했는가? |
강의 중간에 제시되는 문항에서는 방금 배운 내용을 적용하여 지정한 줄의 의미와 결과를 짧게 설명한다.