파이썬 기초 문법 2
제어문(조건문, 반복문)과 함수, 라이브러리
조건문 (if)
상황에 따라 다른 코드를 실행하는 방법
조건문 기본 구조 (if, elif, else)
주어진 조건이 참(True)일 때만
특정 코드를 실행합니다.
- if필수: 가장 먼저 검사하는 조건입니다.
- elif선택: 앞의 조건이 거짓일 때 검사하는 추가 조건입니다.
- else선택: 모든 조건이 거짓일 때 실행됩니다.
- 들여쓰기(Indentation)가 매우 중요합니다. 들여쓰기 된 부분만 조건에 종속됩니다.
if score >= 90:
print("A학점")
elif score >= 80:
print("B학점")
else:
print("C학점 이하")
> B학점
비교 연산자와 논리 연산자
비교 연산자
값의 크기를 비교하여 True/False를 반환합니다.
- == : 같다
- != : 다르다
- >, <, >=, <= : 크기 비교
논리 연산자
여러 조건을 결합합니다.
- and : 양쪽 모두 True일 때 True
- or : 한쪽이라도 True이면 True
- not : 상태를 반대로 뒤집음
연산자 활용 예시
is_student = True
# 두 조건을 모두 만족해야 실행
if age < 30 and is_student == True:
print("청년 학생 할인 적용")
# 조건 중 하나만 만족해도 실행
if age > 65 or age < 8:
print("무료 입장")
조건문과 반복문
조건에 따라 데이터를 골라내고, 같은 작업을 반복하는 방법
반복문 기본 구조 (for)
리스트나 튜플의 데이터를
하나씩 꺼내어 코드를 실행합니다.
- 데이터 개수만큼 반복을 수행합니다.
- 수십, 수백 개의 데이터를 다룰 때 코드를 획기적으로 줄여줍니다.
- 반복문 내부 역시 들여쓰기가 필수입니다.
# 리스트 안의 데이터를 하나씩 fruit에 담아 실행
for fruit in fruits:
print(fruit)
> 사과
> 포도
> 바나나
횟수를 지정하는 range() 함수
리스트 데이터가 없어도 특정 횟수만큼 반복하고 싶을 때 range() 함수를 사용합니다.
- range(종료): 0부터 '종료-1'까지 생성
- range(시작, 종료): '시작'부터 '종료-1'까지 생성
- range(시작, 종료, 간격): 지정한 간격만큼 띄어 생성
for i in range(3):
print(i)
> 0
> 1
> 2
# 1부터 4까지 반복
for i in range(1, 5):
print(i)
> 1
> 2
> 3
> 4
조건이 참인 동안 반복하는 while
조건이 참(True)인 동안
계속 반복합니다.
- 반복 횟수가 정해지지 않고, 특정 조건이 만족될 때까지 반복할 때 사용합니다.
- 조건이 계속 참이면 무한 반복(무한 루프)에 빠지므로, 반복문 안에서 조건을 바꿔주어야 합니다.
- 반복을 즉시 멈추려면 break, 이번 차례만 건너뛰려면 continue를 사용합니다.
n = 1
while n <= 5:
print(n)
n = n + 1
> 1
> 2
> 3
> 4
> 5
# break 로 반복 중단
n = 0
while True:
n = n + 1
if n == 3:
break
print(n)
> 1
> 2
반복문과 조건문의 결합
데이터 분석 시 수많은 데이터 중 특정 조건에 맞는 데이터만 걸러낼 때(Filtering) 두 문법을 조합하여 사용합니다.
주의: 들여쓰기가 두 번 들어갑니다. (for문 내부의 if문 내부)
# 점수를 순회하면서 70점 이상만 출력
for score in scores:
if score >= 70:
print("합격:", score)
> 합격: 90
> 합격: 70
> 합격: 85
[실습 1] 합격 점수 필터링하기
조건문과 반복문을 모두 배운 뒤, 리스트에 담긴 점수에서 80점 이상인 합격 점수만 골라 출력해 봅니다.
과제
- 점수 목록을
for문으로 하나씩 확인합니다. if문으로 80점 이상인지 판정합니다.- 점수 목록이나 기준 점수(80)를 바꿔 결과를 확인합니다.
시작 코드
pass_score = 80
# 반복문과 조건문 결합
for score in scores:
if score >= pass_score:
print("합격 점수:", score)
> 합격 점수: 90
> 합격 점수: 85
> 합격 점수: 100
세트 · 함수 · 라이브러리
데이터를 정리하고, 재사용 가능한 코드와 분석 도구로 확장하기
세트: 중복 없이 항목 모으기
중복을 허용하지 않고
순서를 보장하지 않는 자료형입니다.
- {값1, 값2} 또는 set()으로 만듭니다.
- 빈 세트는 반드시 set()으로 만듭니다. {}는 빈 딕셔너리입니다.
- add()로 추가하고 remove()로 제거합니다.
- discard()는 값이 없어도 오류가 나지 않습니다.
print(languages)
> {'C', 'Python'} # 순서는 달라질 수 있음
languages.add("Java")
languages.remove("C")
languages.discard("Go") # 오류 없음
picked = languages.pop() # 임의 항목 제거·반환
languages.clear() # 모든 항목 제거
print(languages)
> set()
세트를 활용한 집합 연산
두 집단의 공통점과 차이점을 구할 때 세트 연산을 활용하면 반복문 없이 간결하게 처리할 수 있습니다.
- A | B: 합집합 — 양쪽의 모든 항목
- A & B: 교집합 — 양쪽의 공통 항목
- A - B: 차집합 — A에만 있는 항목
- A ^ B: 대칭 차집합 — 한쪽에만 있는 항목
B = {"Python", "Java", "SQL"}
print(A | B)
> {'Python', 'R', 'SQL', 'Java'}
print(A & B)
> {'Python', 'SQL'}
print(A - B)
> {'R'}
print(A ^ B)
> {'R', 'Java'}
※ 세트의 출력 순서는 실행 환경에 따라 달라질 수 있습니다.
함수 (Function)
반복되는 코드에 이름을 붙여 재사용하는 방법
함수(Function): 자주 쓰는 코드에 이름 붙이기
반복되는 코드를 하나로 묶어
이름만 불러 재사용합니다.
- def 키워드로 함수를 정의합니다.
- 같은 작업을 여러 번 할 때 코드를 복사하지 않고 함수를 호출합니다.
- 코드가 짧아지고, 수정할 때도 한 곳만 고치면 됩니다.
def greet():
print("안녕하세요!")
# 함수 호출 (여러 번 재사용)
greet()
greet()
> 안녕하세요!
> 안녕하세요!
매개변수(Parameter)와 반환값(return)
함수에 값을 넣어(매개변수) 처리하고, 그 결과를 돌려받을(return) 수 있습니다.
- 매개변수: 함수가 호출될 때 전달받는 값 (괄호 안에 정의)
- return: 함수의 처리 결과를 함수 밖으로 돌려줌
- return 이 없으면 결과를 변수에 담아 재사용할 수 없습니다.
def add(a, b):
return a + b
result = add(3, 5)
print(result)
> 8
# 반환값을 다른 계산에 재사용
print(add(10, 20) * 2)
> 60
라이브러리 (Library)
이미 만들어진 도구를 불러와 데이터 분석에 활용하기
표준 라이브러리와 서드파티 라이브러리
라이브러리는 이미 만든 코드를 모아 재사용하게 해 줍니다. 설치 여부에 따라 두 종류로 구분할 수 있습니다.
- 표준 라이브러리: 파이썬에 기본 포함되어 바로 사용합니다. 예: math, random
- 서드파티 라이브러리: 별도로 개발·배포됩니다. 예: NumPy, pandas, matplotlib
- Google Colab에는 주요 데이터 분석 라이브러리가 미리 설치되어 있습니다.
import math
print(math.sqrt(16))
> 4.0
print(math.pi)
> 3.141592653589793
# 필요한 함수만 불러오기
from math import sqrt
print(sqrt(25))
> 5.0
# 서드파티 라이브러리와 별칭
import pandas as pd
데이터 분석의 세 가지 핵심 라이브러리
수치 계산
빠른 N차원 배열과 과학 계산 기능을 제공합니다.
arr = np.array([1, 2, 3])
표 데이터 분석
Series와 DataFrame으로 CSV·엑셀 같은 표 데이터를 다룹니다.
df = pd.DataFrame(data)
데이터 시각화
선·막대·히스토그램·파이 등 다양한 그래프를 그립니다.
plt.plot([1, 2, 3])
NumPy로 계산 → pandas로 표를 다룸 → matplotlib으로 결과를 시각화
NumPy 배열: 리스트보다 계산에 알맞은 구조
list는 여러 값을 담는 기본 상자, NumPy 배열(ndarray)은 숫자를 한꺼번에 계산하는 상자입니다.
- 리스트: 숫자·글자 등 서로 다른 자료를 순서대로 담기 좋습니다.
- 튜플: 리스트와 비슷하지만 만든 뒤 값을 바꿀 수 없습니다.
- 딕셔너리:
키: 값으로 이름을 붙여 데이터를 찾기 좋습니다. - NumPy 배열: 보통 같은 자료형의 숫자를 담고, 배열 전체에 빠르게 계산합니다.
같은 데이터, 다른 계산
scores = [80, 90, 70]
doubled = []
for score in scores:
doubled.append(score * 2)
import numpy as np
arr = np.array([80, 90, 70])
print(arr * 2)
> [160 180 140]
print(arr.mean())
> 80.0
Matplotlib으로 점수 그래프 그리기
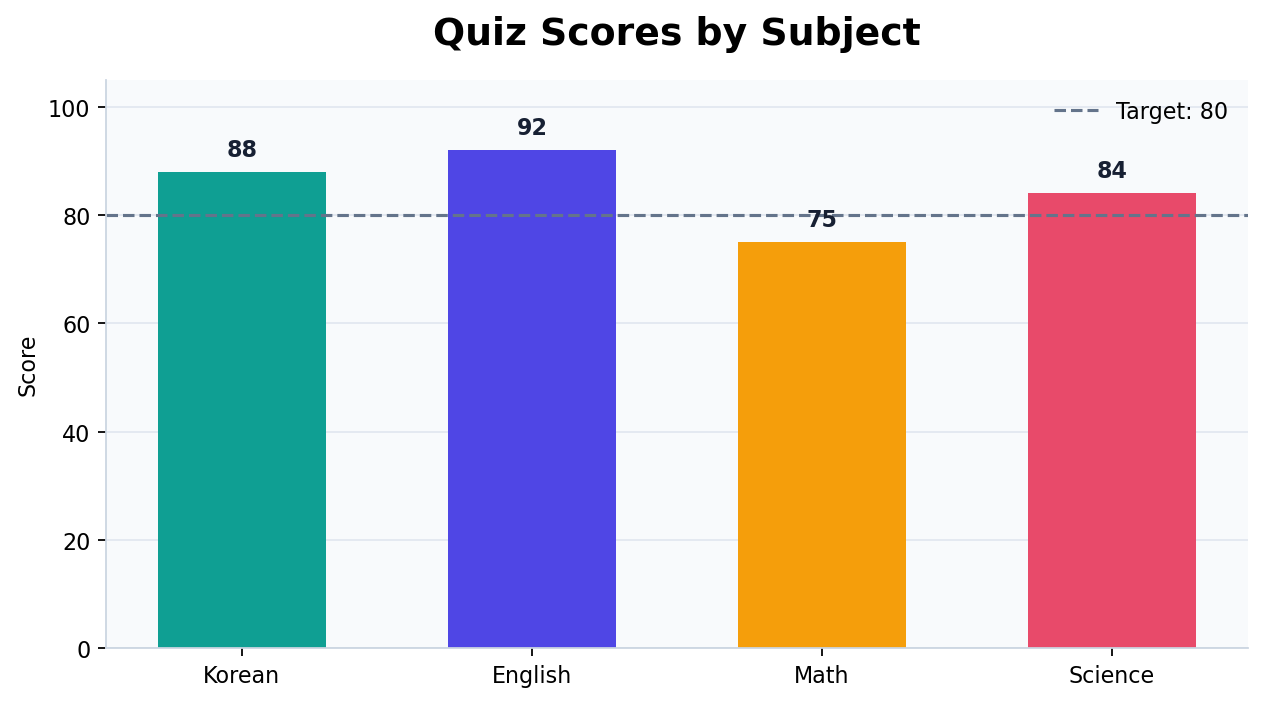
아래 그래프는 오른쪽의 Matplotlib 코드로 실제 파이썬에서 생성한 결과입니다.
subjects = ["Korean", "English", "Math", "Science"]
scores = [88, 92, 75, 84]
plt.bar(subjects, scores)
plt.axhline(80, linestyle="--")
plt.title("Quiz Scores by Subject")
plt.show()
막대의 높이로 과목별 점수를 비교하고, 점선으로 목표 점수 80을 표시했습니다.
Pandas의 핵심 구조: Series와 DataFrame
Pandas는 리스트·튜플·딕셔너리 위에, 이름표(index·column)와 표 기능을 더한 데이터 도구입니다.
Series (시리즈) = 이름표가 있는 1차원 열
리스트처럼 한 줄의 값을 담지만, 위치뿐 아니라 인덱스 이름으로도 값을 찾고 통계 계산을 할 수 있습니다.
DataFrame (데이터프레임) = 여러 열이 모인 2차원 표
딕셔너리처럼 열 이름을 쓰되, 모든 열을 같은 행 기준으로 정렬·필터링·분석합니다. 열마다 숫자와 글자를 함께 담을 수 있습니다.
정리: list/tuple은 순서 중심 · dict는 키-값 중심 · Series는 라벨이 있는 한 열 · DataFrame은 라벨이 있는 전체 표
Series와 DataFrame
ages = pd.Series([22, 25], index=["가석현", "김철수"])
print(ages["가석현"]) # 22
df = pd.DataFrame({
"이름": ["가석현", "김철수"],
"나이": [22, 25]
})
print(df["나이"].mean()) # 23.5
| 인덱스 | 이름 | 나이 |
|---|---|---|
| 0 | 가석현 | 22 |
| 1 | 김철수 | 25 |
딕셔너리로 DataFrame 만들기
딕셔너리(Dictionary)와 리스트(List)를 조합하면 표를 손쉽게 만들 수 있습니다.
- 딕셔너리의 키(Key)는 열 이름(Column)이 됩니다.
- 딕셔너리의 값(Value) 리스트는 열의 데이터가 됩니다.
# 딕셔너리로 데이터 준비
data = {
"이름": ["가석현", "김철수", "이영희"],
"점수": [90, 85, 95]
}
# DataFrame으로 변환
df = pd.DataFrame(data)
print(df)
딕셔너리와 DataFrame, 언제 달라질까?
작은 표에서는 둘 다 비슷해 보입니다. 차이는 표 전체를 필터링·정렬·분석할 때 드러납니다.
딕셔너리: 값을 담는 기본 자료형
값을 찾고 반복문으로 직접 처리하기에 좋습니다. 조건에 맞는 학생의 이름과 점수를 함께 남기려면 반복문과 새 리스트를 직접 작성해야 합니다.
DataFrame: 행·열을 다루는 분석 도구
조건 하나로 해당 행 전체를 골라내고, 열 기준 평균·정렬·파일 저장을 바로 할 수 있습니다.
90점 이상 학생 찾기
# dict: 반복문으로 직접 새 목록 만들기
passed = []
for i in range(len(data["점수"])):
if data["점수"][i] >= 90:
passed.append(data["이름"][i])
print(passed) # ['민지', '서연']
# DataFrame: 조건에 맞는 행 전체를 선택
df = pd.DataFrame(data)
print(df[df["점수"] >= 90])
# 이름과 점수가 함께 남음
외부 데이터 파일 읽어오기 (CSV)
실무에서는 데이터를 직접 입력하지 않고, CSV(쉼표로 구분된 텍스트) 같은 파일을 불러와 분석합니다.
- pd.read_csv("파일명.csv"): 대표적인 데이터 로드 함수
- df.head(): 데이터의 상위 5개 행 미리보기
# CSV 파일 읽어오기
df = pd.read_csv("seoul_subway.csv")
# 상위 5개 행 미리보기
print(df.head())
데이터 파일은 노트북 파일(.ipynb)과 같은 폴더에 있어야 합니다.
print 와 return, 무엇이 다를까?
입문자가 가장 자주 헷갈리는 부분입니다. print 는 화면에 보여주는 것, return 은 값을 돌려주는 것입니다.
- print(): 결과를 화면에 출력만 하고, 값은 남지 않습니다.
- return: 값을 함수 밖으로 돌려주어 변수에 저장하거나 다른 계산에 쓸 수 있습니다.
- 데이터 분석에서는 계산 결과를 return 으로 받아 이어서 처리하는 경우가 많습니다.
def add_print(a, b):
print(a + b)
x = add_print(2, 3) # 5 출력
print(x)
> None
# return 을 사용한 함수 (값을 돌려받음)
def add_return(a, b):
return a + b
y = add_return(2, 3)
print(y * 10)
> 50
[실습 2] 나만의 성적표 만들기
지금까지 배운 조건문·반복문·세트·함수·Pandas를 모두 사용해 간단한 성적표를 완성해 봅니다.
수행 목표
- 함수에서 점수를 A/B/C 학점으로 판정하기 (90점 이상 A · 80~89점 B · 80점 미만 C)
- 반복문으로 과목별 학점을 만들고, 합격 과목을 세트에 담기
- Pandas DataFrame으로 나만의 성적표 출력하기
시작 코드
subjects = ["국어", "영어", "수학"]
scores = [88, 92, 75]
def grade(score):
if score >= 90:
return "A"
elif score >= 80:
return "B"
else:
return "C"
grades = []
passed_subjects = set()
for i in range(len(scores)):
grades.append(grade(scores[i]))
if scores[i] >= 60:
passed_subjects.add(subjects[i])
df = pd.DataFrame({"과목": subjects, "점수": scores, "학점": grades})
print(df)
print("합격 과목:", passed_subjects)
[실습 3] 라이브러리를 활용한 계산
표준 라이브러리 math 를 불러와, 반복문과 함수를 함께 활용한 계산을 해 봅니다.
수행 목표
- import 로 라이브러리 불러오기
- 모듈.함수() 형태로 기능 호출하기
- 반복문으로 여러 값 처리하기
실습 가이드 코드
import math
# 1. 제곱근 구하기
print(math.sqrt(144))
> 12.0
# 2. 반복문으로 1~5 의 제곱근 출력
for i in range(1, 6):
print(i, round(math.sqrt(i), 2))
> 1 1.0
> 2 1.41
> 3 1.73
> 4 2.0
> 5 2.24
[실습 4] 나만의 BMI 계산기 함수 만들기
키와 몸무게를 입력받아 BMI(체질량지수)를 계산하고 반환하는 함수를 만들어 봅니다.
수행 목표
def키워드로 함수 생성하기- 매개변수 2개(체중, 키) 전달하기
return으로 결과값 반환하기
실습 가이드 코드
def calc_bmi(weight, height_m):
bmi = weight / (height_m ** 2)
return bmi
my_weight = 70
my_height = 1.75
result = calc_bmi(my_weight, my_height)
print("나의 BMI 지수:", round(result, 2))
[실습 5] 딕셔너리로 표(DataFrame) 만들기
Pandas를 불러와 가상의 성적 데이터를 엑셀처럼 표 구조로 만들어 봅니다.
수행 목표
import pandas as pd로 라이브러리 호출하기- 딕셔너리와 리스트 조합으로 데이터 만들기
pd.DataFrame()변환 결과 확인하기
실습 가이드 코드
raw_data = {
"과목": ["국어", "영어", "수학"],
"점수": [88, 92, 75],
"학점": ["B+", "A", "C+"]
}
df = pd.DataFrame(raw_data)
print(df)
실습 및 LXP 퀴즈 안내
실습 1 실행
코랩(Colab)에서 조건문과 반복문을 사용해 80점 이상인 합격 점수만 골라 출력합니다.
실습 2 실행
함수·조건문·반복문·세트·Pandas를 활용해 나만의 성적표를 만들고 결과를 확인합니다.
LXP 퀴즈 풀기
LXP의 [5주 차 퀴즈]에 접속해 수업 내용을 복습한 뒤, 지정된 기한 안에 모든 문항을 풀고 제출합니다.